동작인식 콘텐츠 제작과 관람객 참여 사례
동작인식 콘텐츠는 RGB카메라나 뎁스 센서로 관람객의 움직임을 읽어, 그 움직임을 화면 속 캐릭터의 동작이나 파티클 효과 등으로 바꿔주는 콘텐츠입니다. 별도의 터치나 조작 없이 몸짓만으로 화면을 움직일 수 있어, 남녀노소 누구나 부담 없이 참여할 수 있는 것이 특징입니다. 손을 흔들거나 몸을 움직이는 동작 하나만으로도 화면에 즉각적인 반응이 나타나기 때문에, 지나가던 사람도 자연스럽게 발걸음을 멈추고 참여하게 되는 경우가 많습니다. 이런 특징 덕분에 전시장 안내존이나 팝업스토어, 미디어파사드처럼 유동인구가 많은 공간에서 특히 활용도가 높습니다. 이 글에서는 라온스퀘어가 실제로 구축한 사례를 통해 동작인식이 화면에 반영되는 방식을 살펴봅니다.
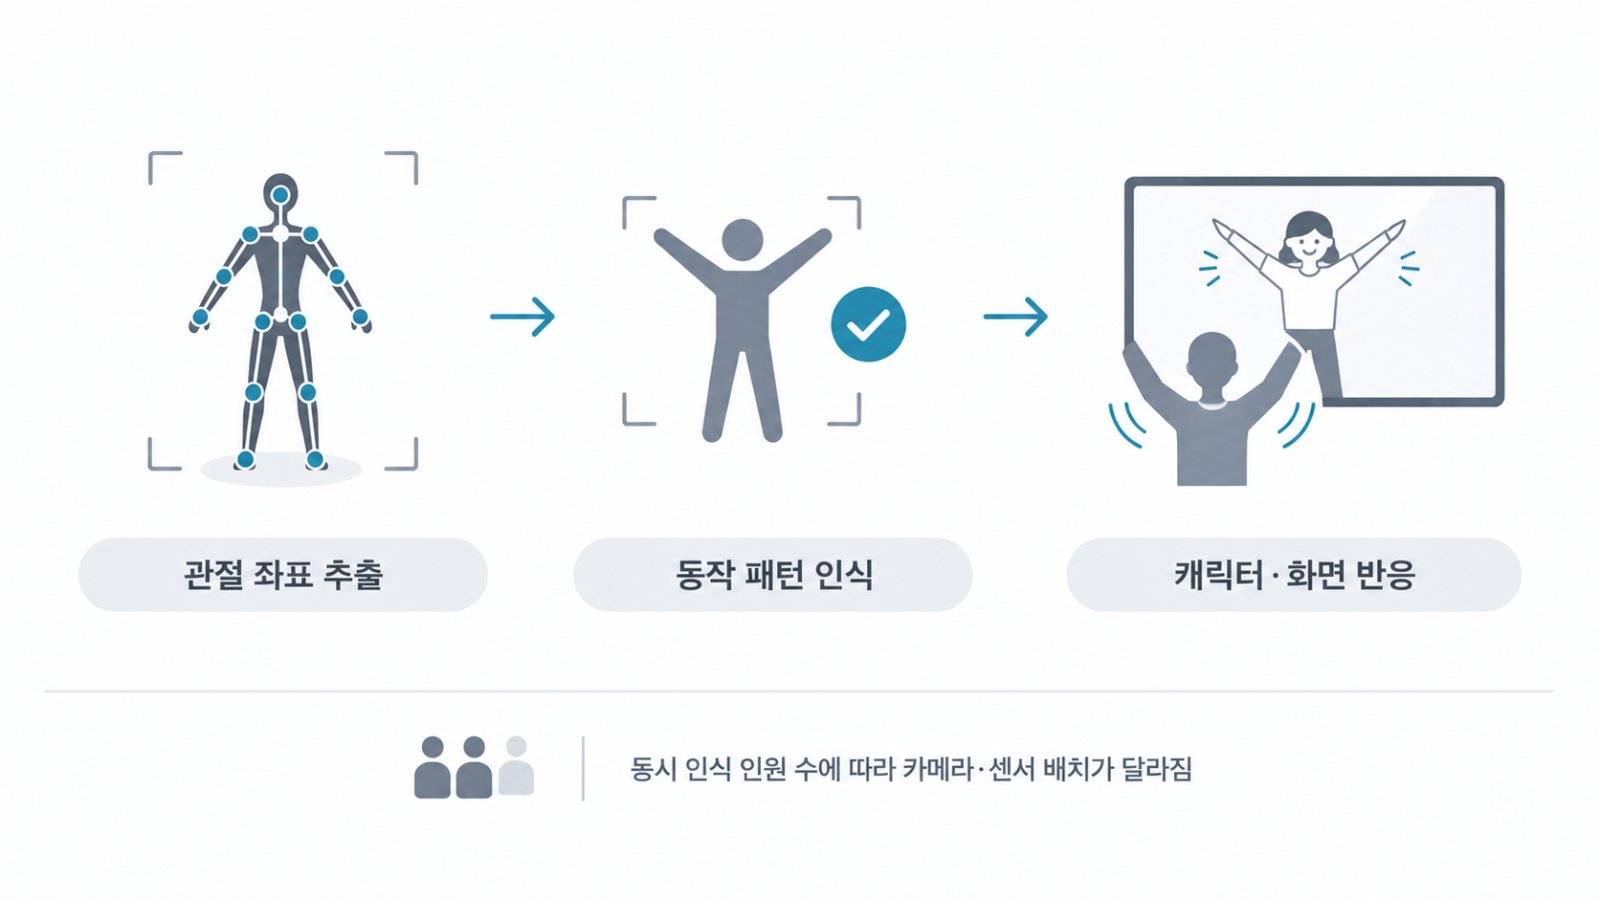
동작인식 콘텐츠의 처리 과정
관절 좌표를 추출해 특정 동작을 인식하고, 그 동작을 캐릭터의 움직임이나 화면 반응으로 연결하는 과정을 거칩니다. 어떤 동작까지 인식할지, 몇 명까지 동시에 인식할지에 따라 필요한 센서와 카메라 배치가 달라집니다.
라온스퀘어 실제 사례
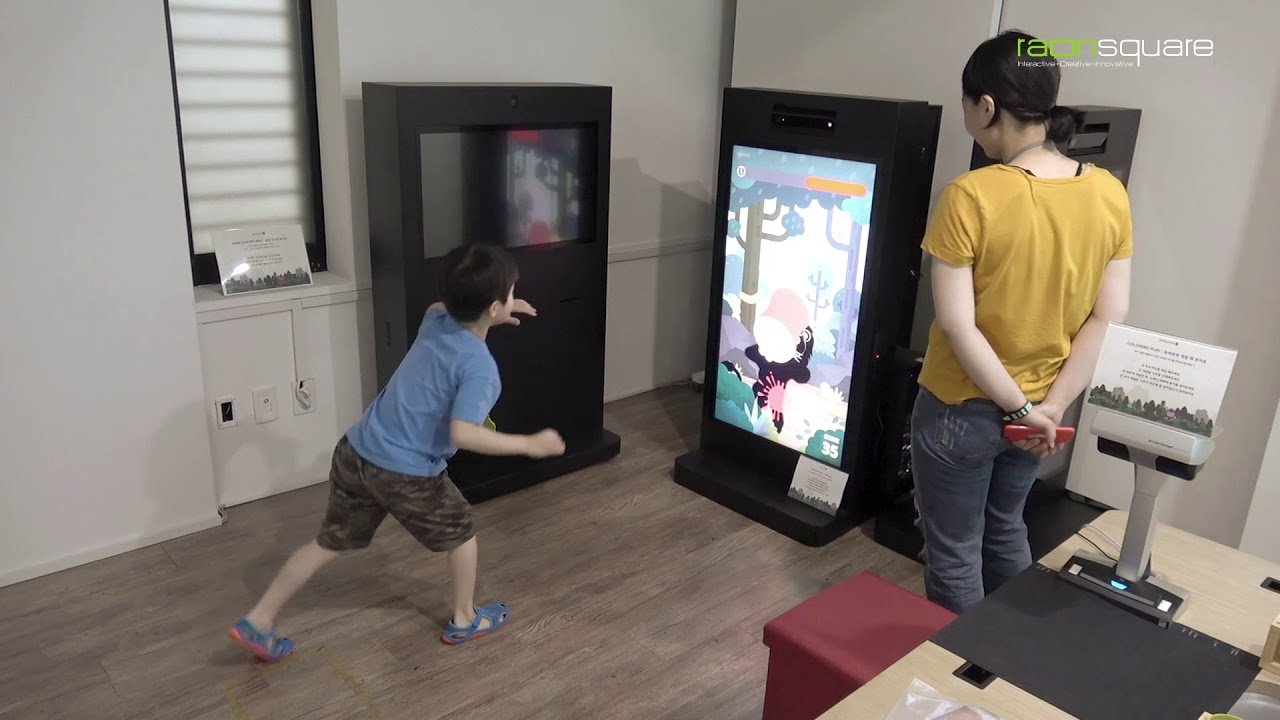
1.RGB 카메라
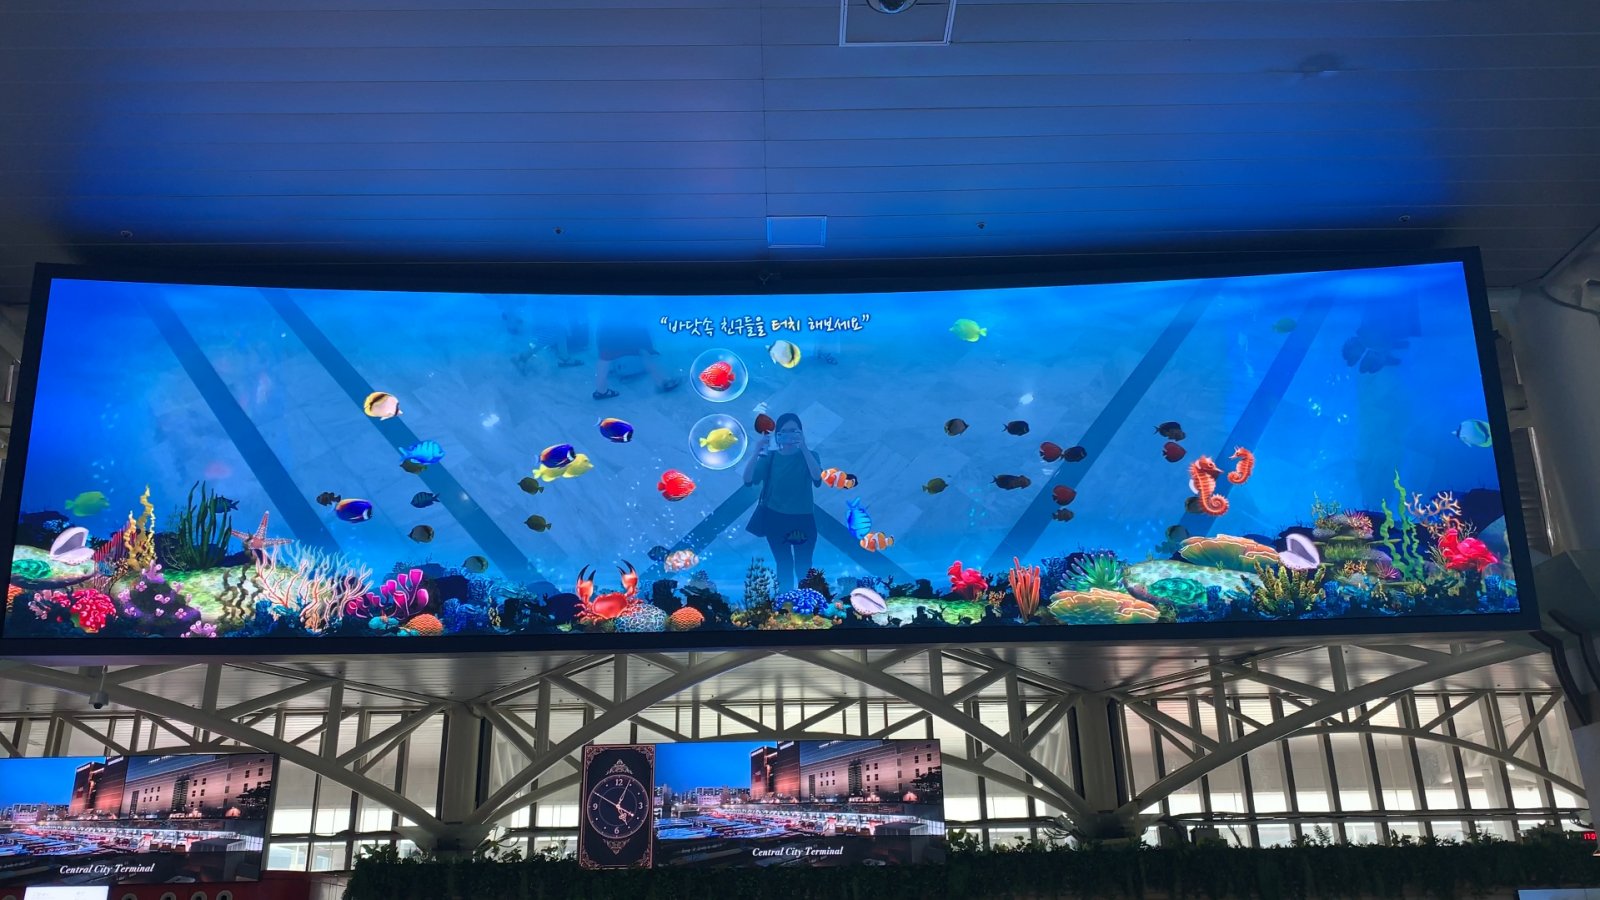
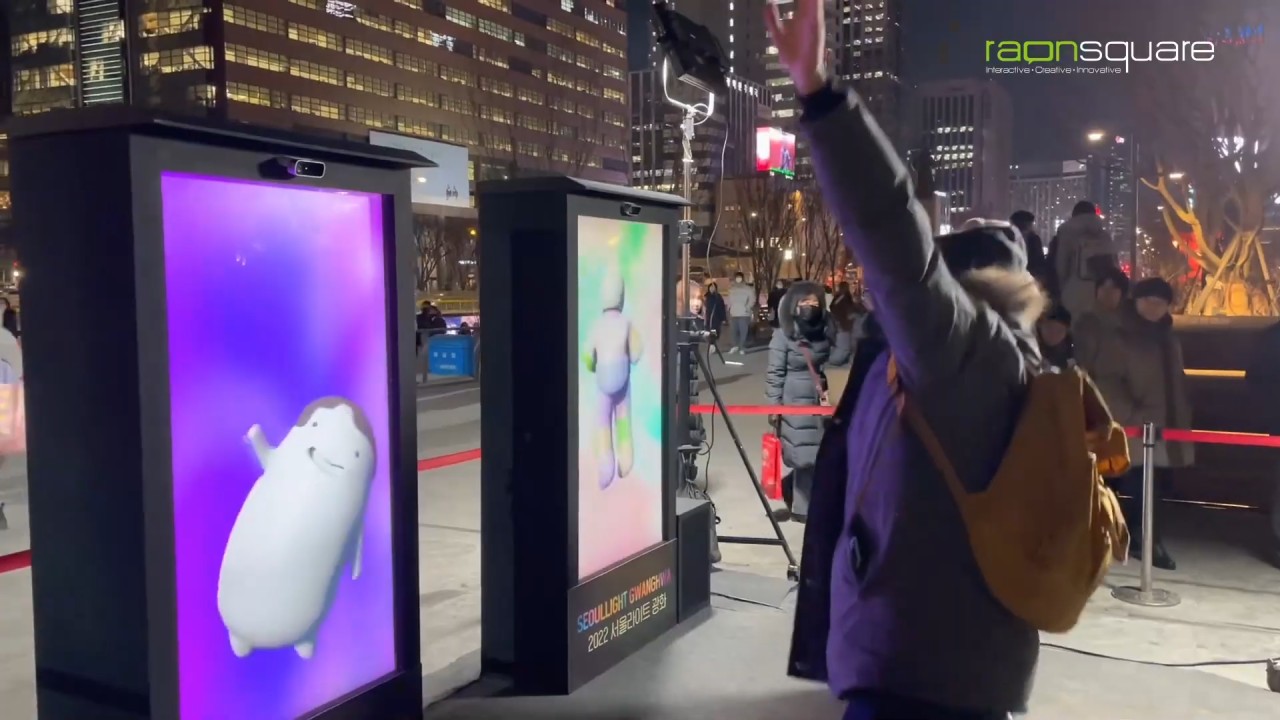
2.뎁스 센서(키넥트)기반 카메라
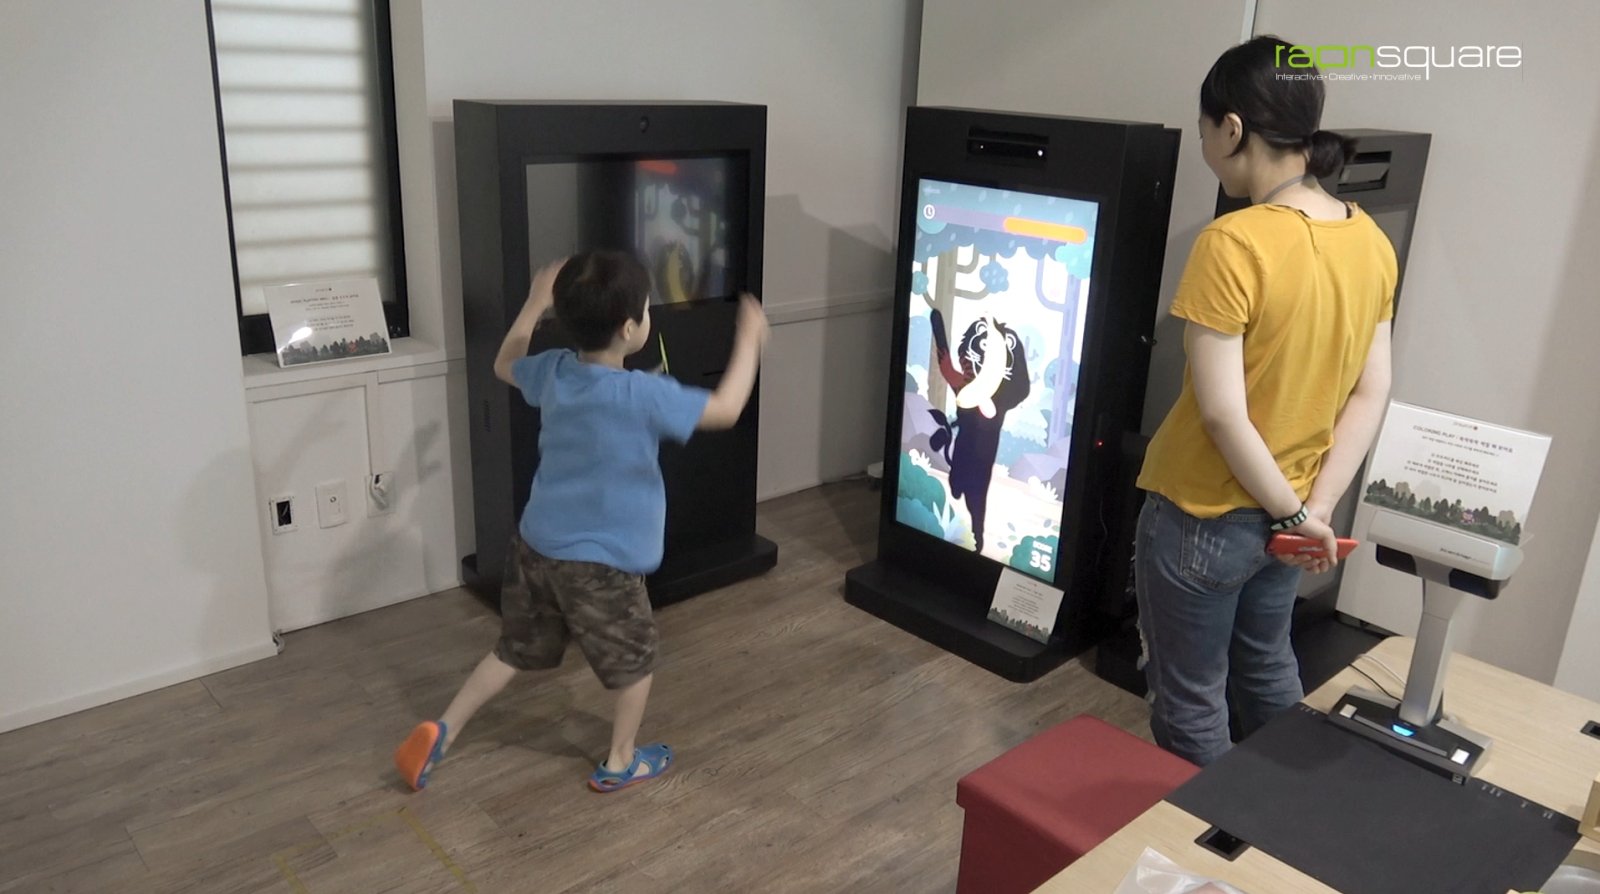
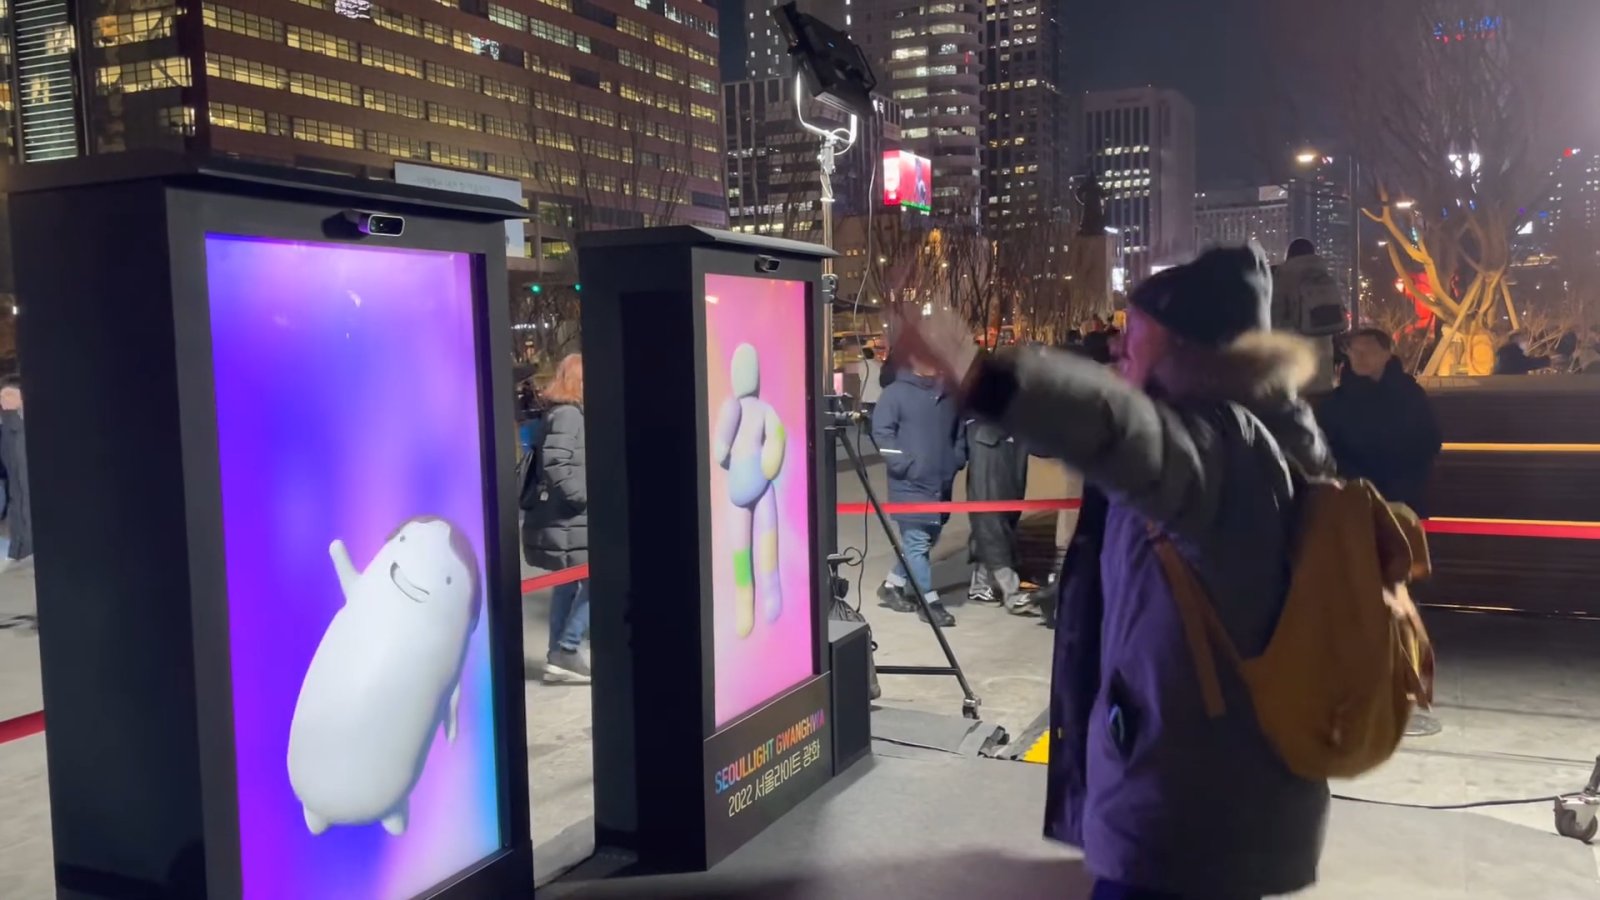
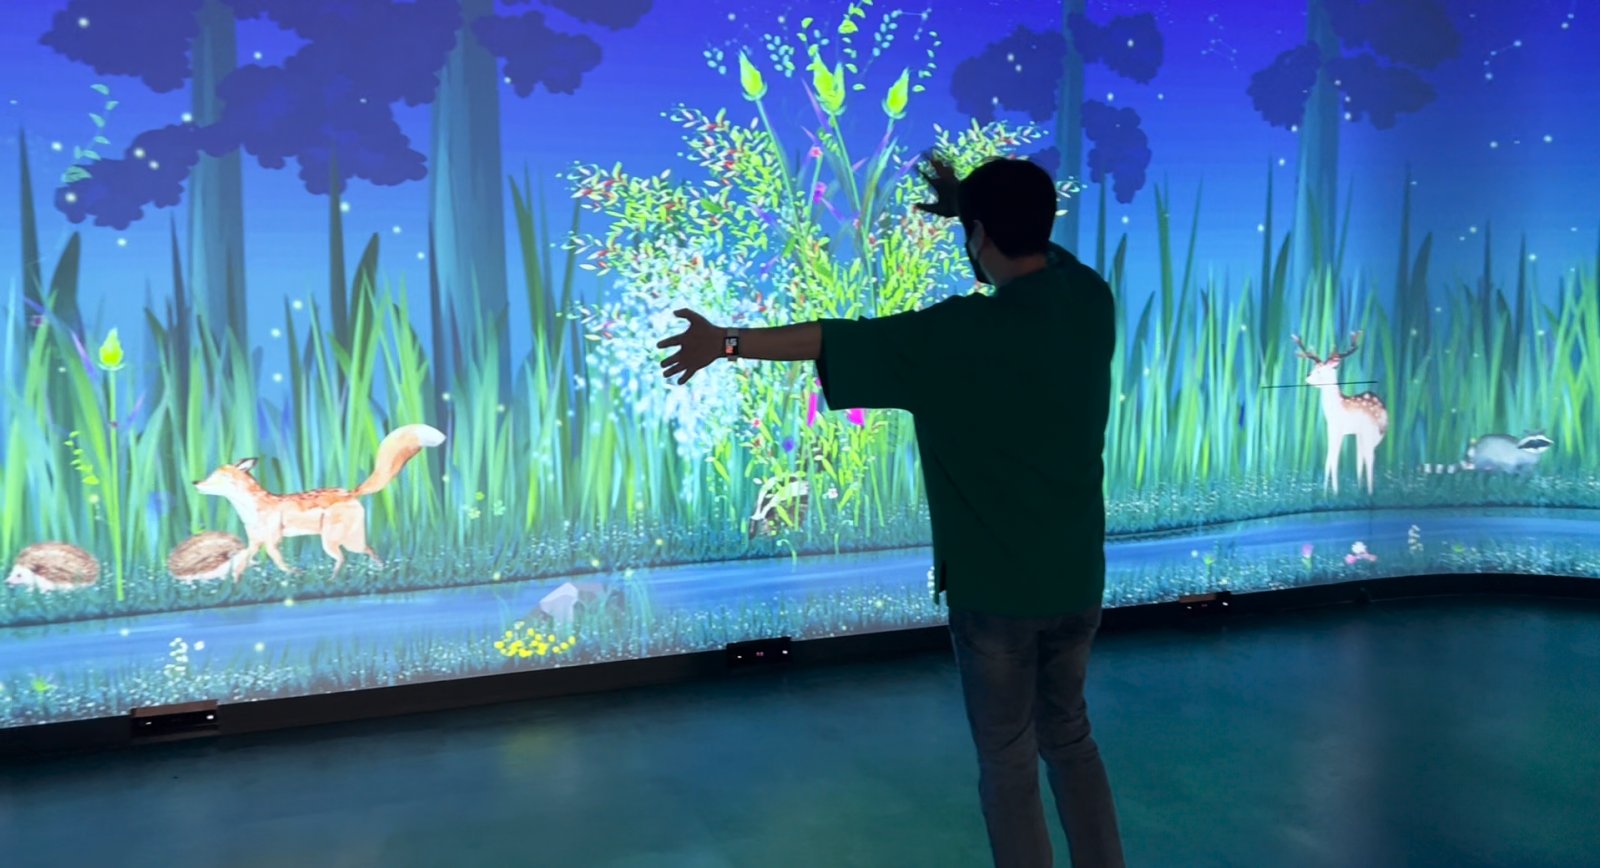
인식 범위 확장과 다인 동시 인식
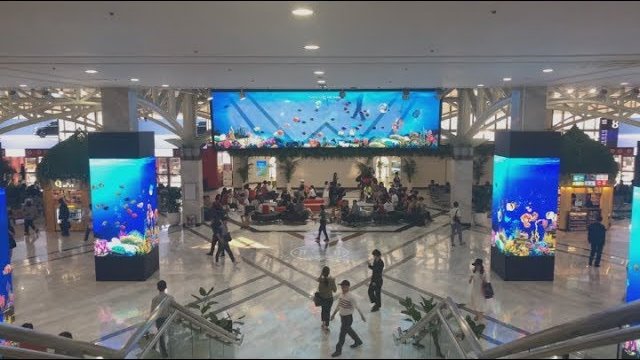
센서 방식에 따라 확장 및 구축 전략이 달라집니다. RGB 카메라는 센서 자체는 저렴하지만 과거엔 조명이나 배경에 따라 인식률이 떨어졌고, 최근에는 AI 기술로 정밀 인식이 가능해졌으나 고사양 로컬 PC(GPU)를 세팅해야 해 초기 하드웨어 비용이 큽니다. 그렇다고 클라우드 Vision AI API를 활용해 초기 비용을 낮추면, 키오스크 특성상 프레임 단위 실시간 호출 과금이 누적되어 1년 이상 장기 운영 시 월 구독료가 고사양 PC 단발성 구매 비용보다 커지는 역전 현상이 발생합니다. 반면 키넥트 같은 뎁스 센서는 센서가 3차원 깊이(Depth) 데이터를 직접 처리해 PC 부담을 줄이고 관절을 안정적으로 추적하지만, 강한 직사광선 환경에 취약합니다. 결국 측면까지 동작 인식을 확장하려면 각 방식에 맞는 카메라·센서 추가 배치와 알고리즘이 고려되어야 하며, 센트럴시티 사례처럼 다중 디스플레이가 연동될 때는 한 화면의 반응이 다른 화면으로 이어지도록 서버 간 네트워크 연결까지 함께 설계해야 합니다.
자주 묻는 질문
Q. 여러 명이 동시에 각자 다른 대상을 터치하거나 움직이면 화면이 각각 다르게 반응하나요?
A. 센트럴시티 사례처럼 터치한 대상별로 이동 경로나 반응 화면을 구분해 설계하면, 여러 명이 동시에 참여해도 각자의 조작이 서로 다른 결과로 이어지도록 구성할 수 있습니다. 다만 몇 명까지 동시에 구분할지는 설치할 카메라·센서 사양에 따라 확인이 필요합니다.
Q. 옷 색깔이 어둡거나 조명이 흐린 공간에서도 동작인식이 잘 되나요?
A. 키넥트 같은 뎁스 센서는 적외선을 쏘아 반사되는 패턴으로 거리를 측정하기 때문에 일반 카메라보다는 조명 밝기 변화에 강한 편입니다. 다만 완전 검정색이나 무광 소재의 옷은 적외선을 흡수해버려 반사광이 충분히 돌아오지 않고, 그 부분의 인식이 다른 색 옷보다 불안정해질 수 있습니다. 이런 이유로 참여자에게 특정 색상의 옷을 안내하기는 어렵지만, 필요하다면 인식 안정성이 중요한 시연에서는 이런 특성을 감안해 민감도를 조정하는 방식으로 대응합니다.